我的 AI 产品实践
你的下一个 Agent 产品,不一定需要有 Agent
探索人与 AI 的最佳协作方式
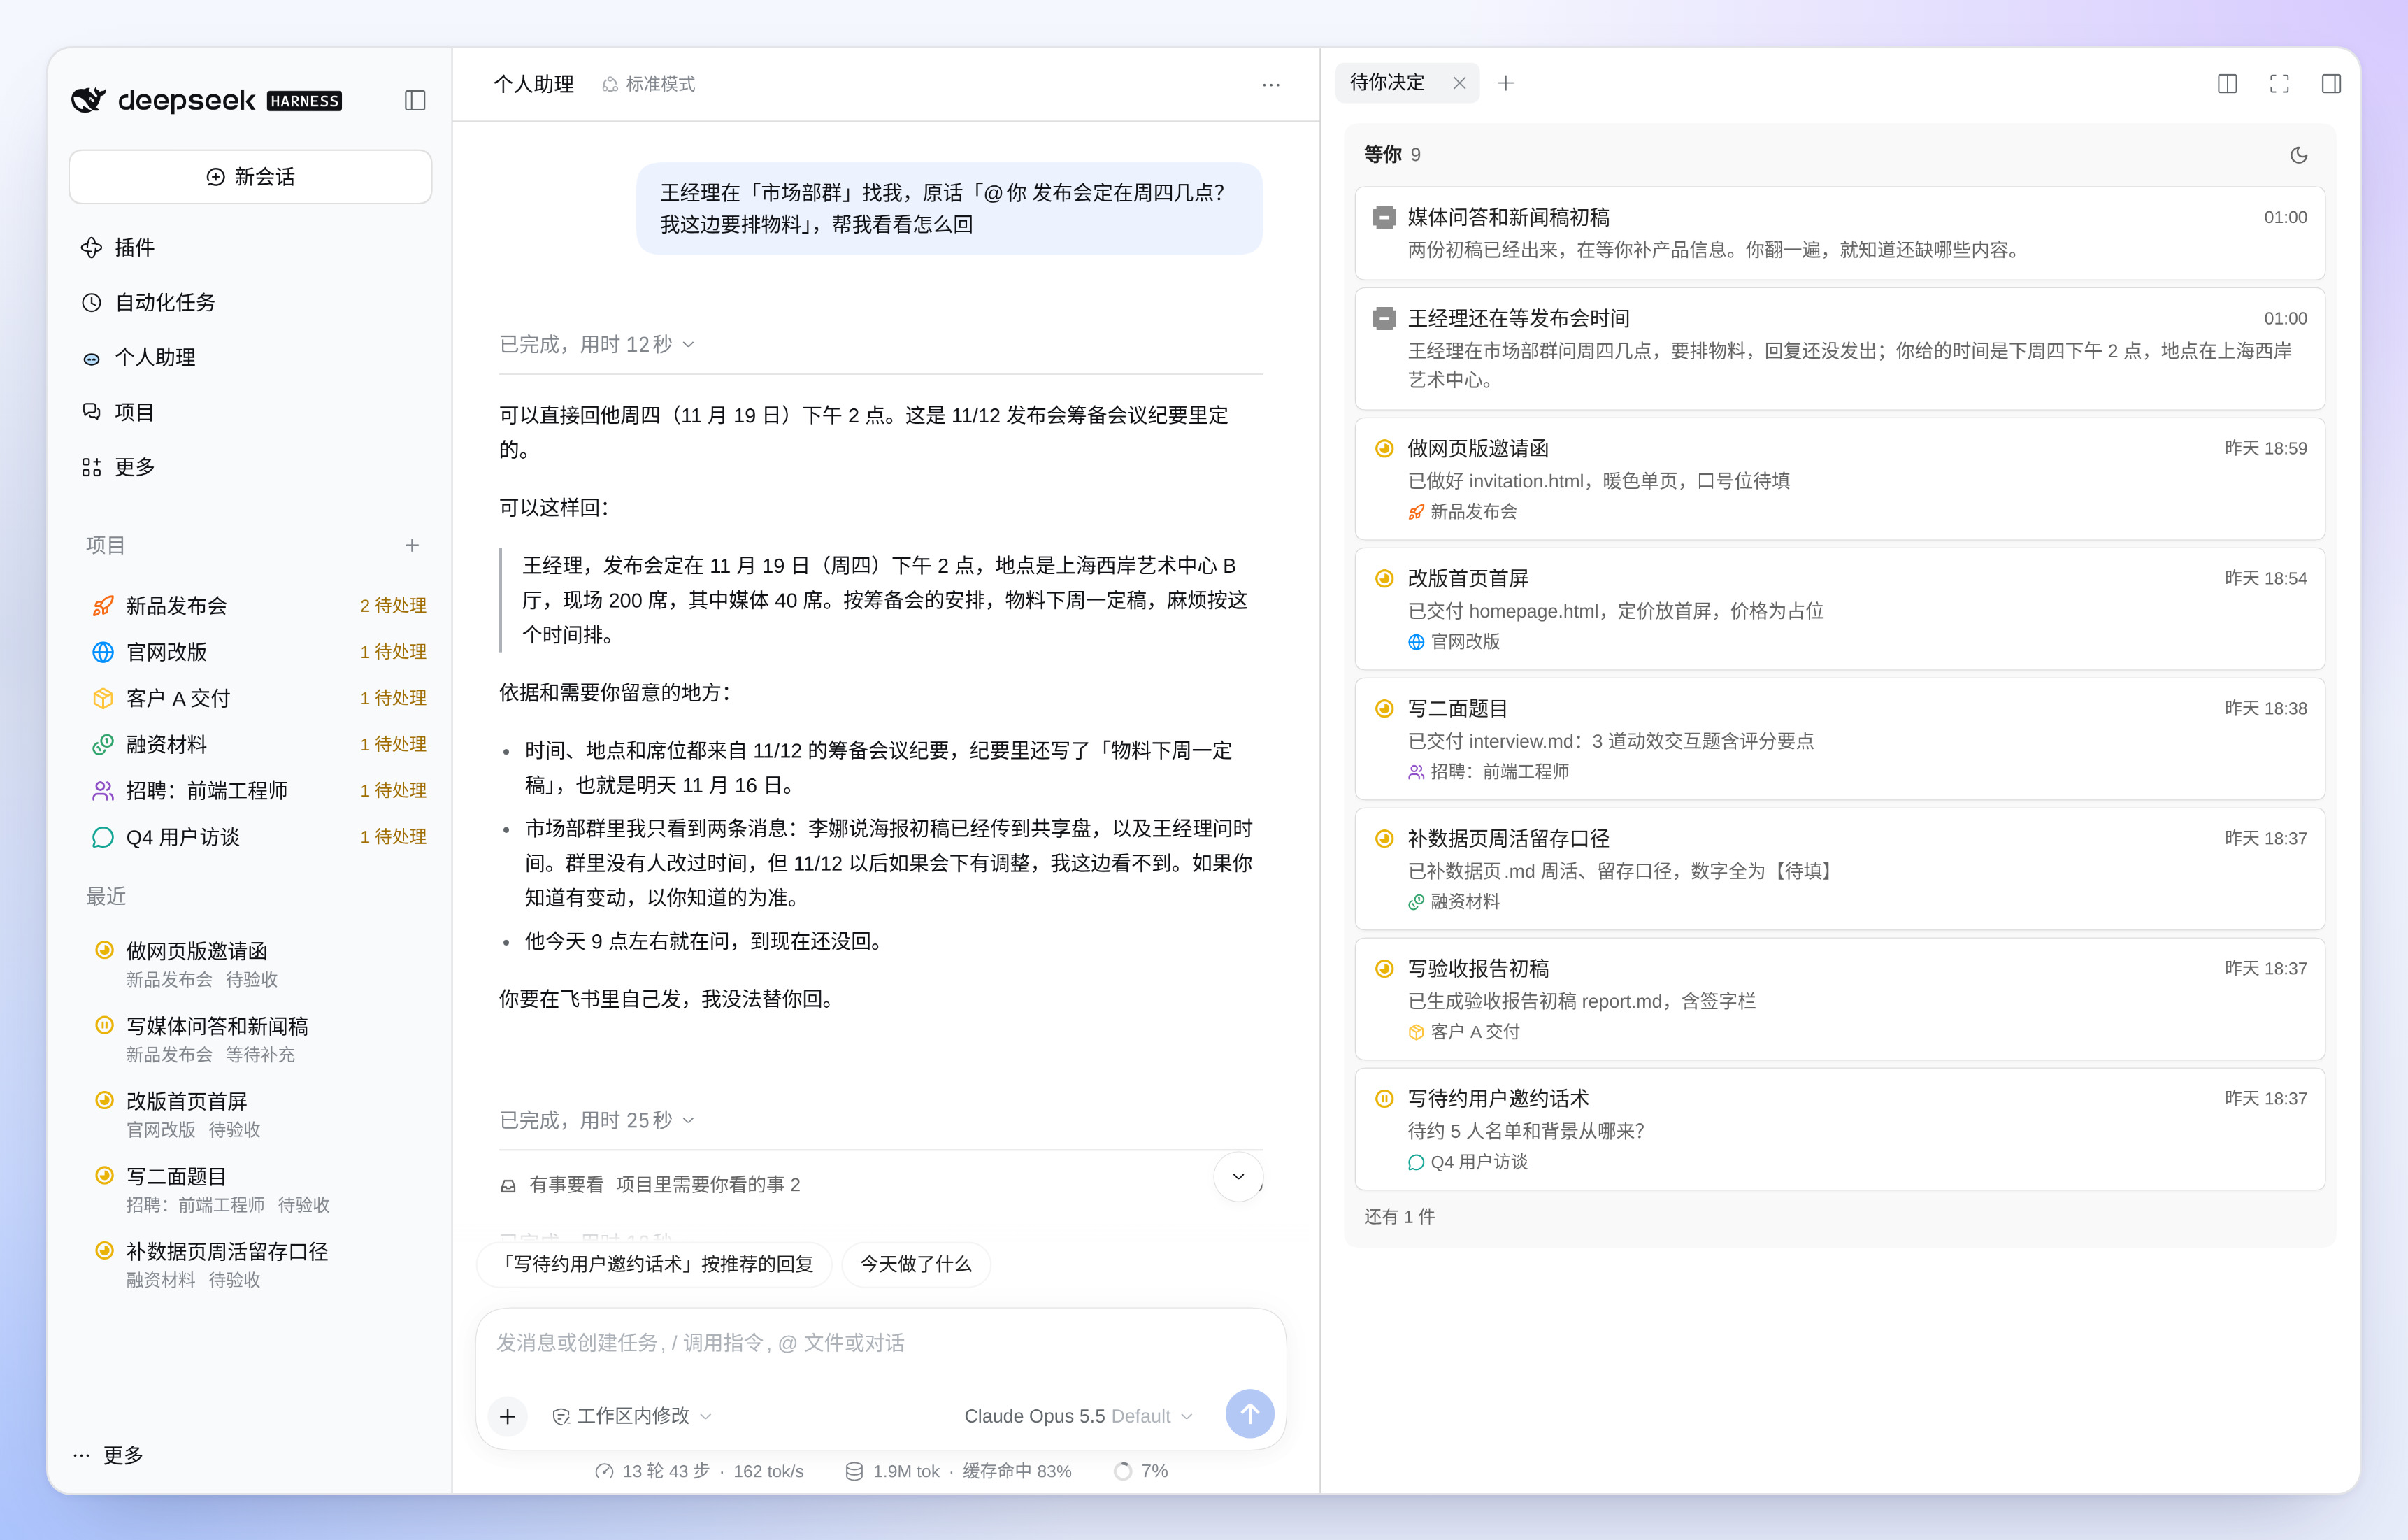
最近半年,我最大的感受是:agent 越来越能干。一方面惊叹于 AI 能力的进步,另一方面却发现自己的效率提升很有限,常常自己在多个对话中奔命。
今天的 AI 应用产品,最核心、最紧迫的问题,就是去降低人和 AI 之间沟通的带宽。一方面,我们需要有很好的方式去把上下文交给 AI;另一方面,又不能让人为此付出更多的注意力。
我们常常面临的困境是:我们疲于奔命,绝大多数时候都在扮演胶水的角色,搬运上下文,却缺少真正的时间来思考,给出正确的方向。
今天的 Agent 产品在构建的时候,错把「组织人」的经验套在了 AI 身上,希望开启越来越多的 agent,却没有考虑到,所谓多 Agent 协作,就会退化成「多个会说话的角色」。它看起来像协作,本质上却还是在模拟人的会议室。
因此,讨论多 agent 之前,我们必须先来讨论一个问题。
我们真的需要那么多 agent 吗?
Fork vs subagent:管理 agent 的本质是管理 context。
什么时候需要 fork,什么时候需要多 agent?答案是,绝大多数时候我们都不需要多 agent。
fork 是共享:新分支天生拥有主对话的上下文。多 agent 是传递:压缩、复述、再理解,传递每多一层,损耗就多一分。就像人和人之间传话会产生误差一样,多 agent 也会产生误差,还增加了不必要的通讯成本。
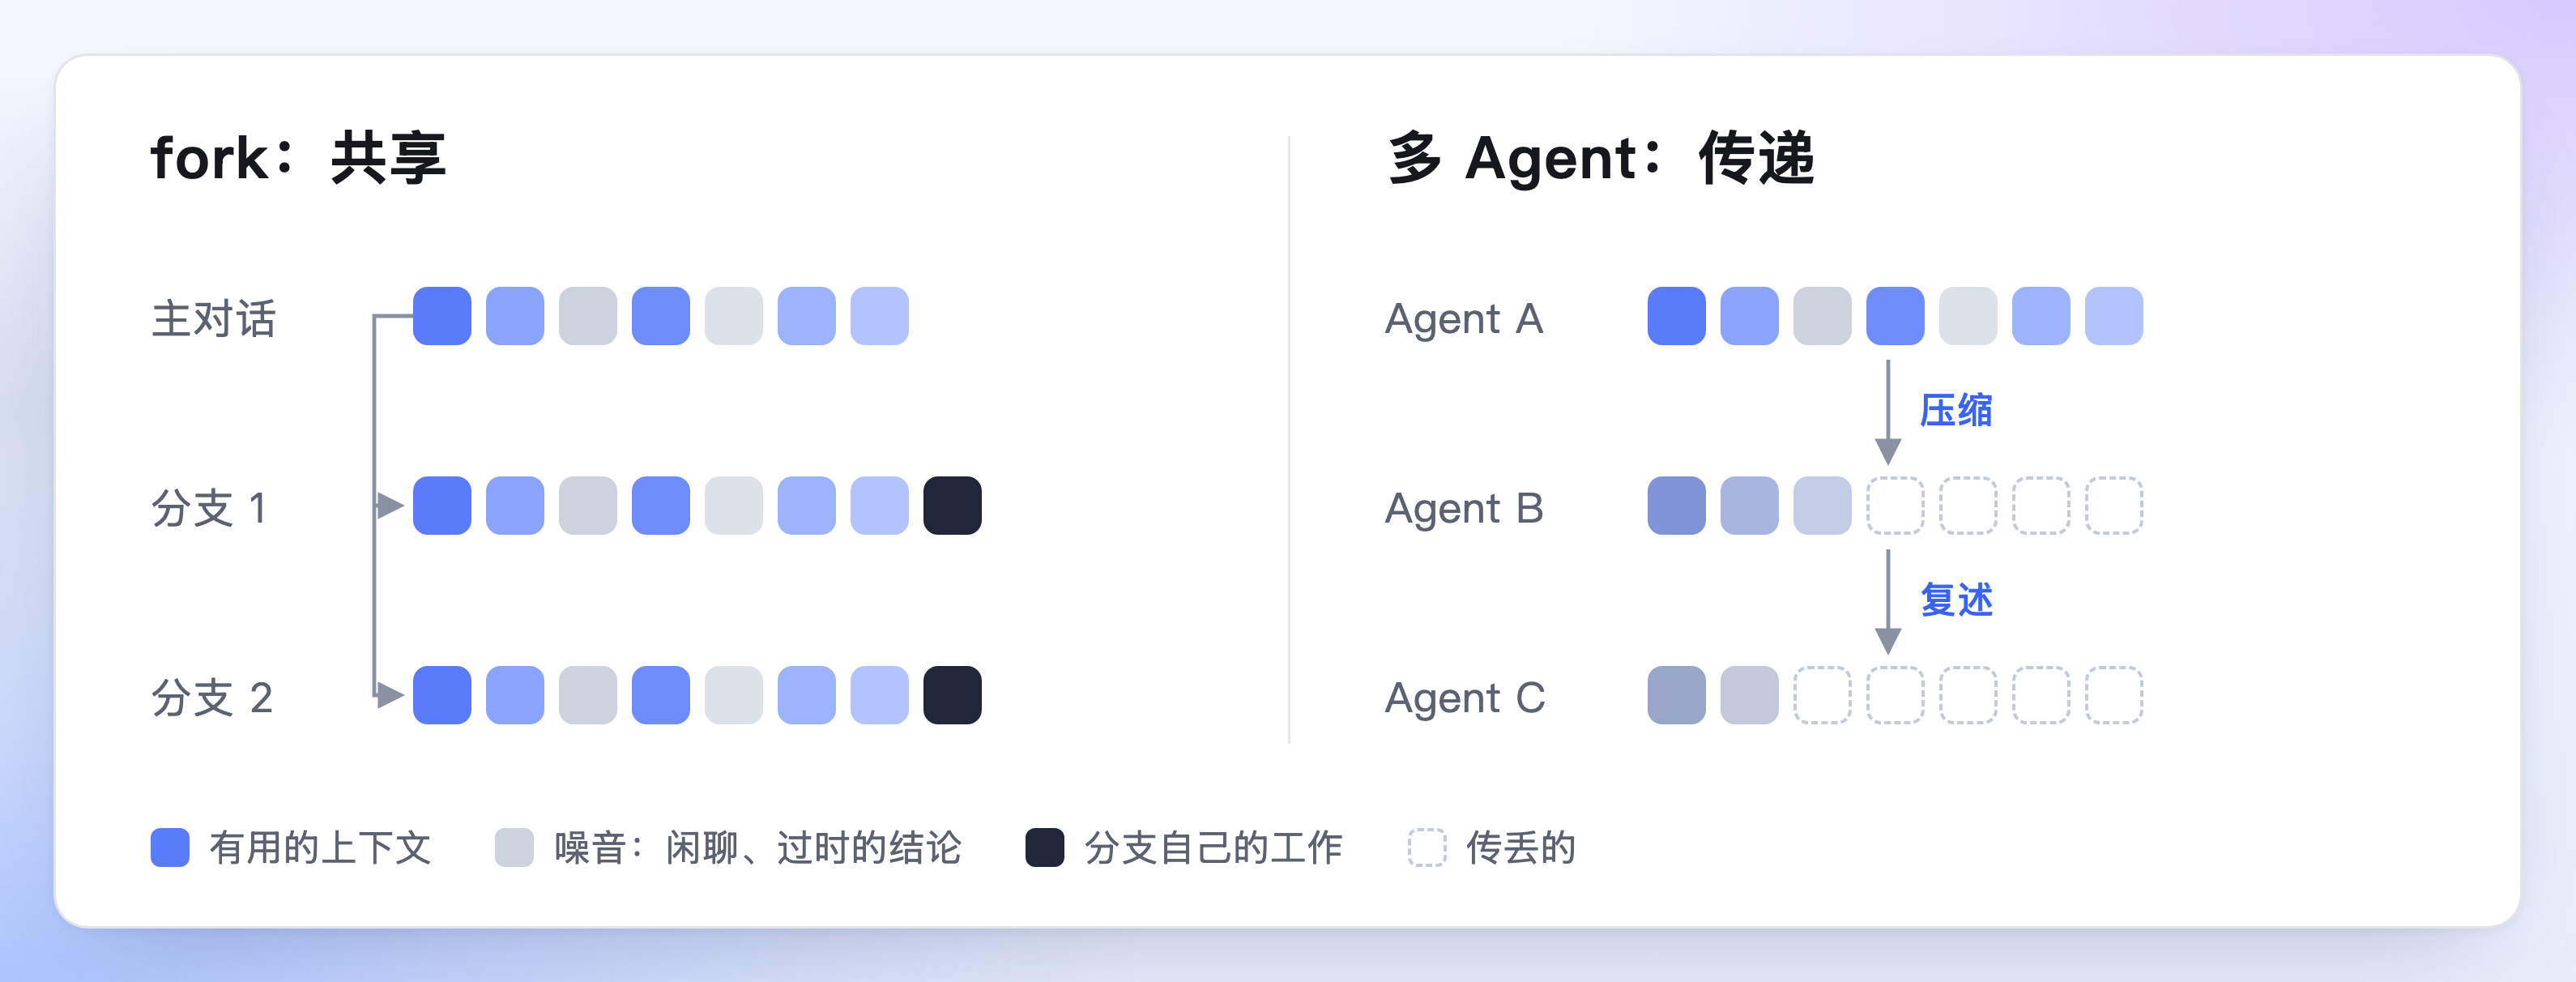
但仅有 fork 也不够,主对话会越来越膨胀。靠对话自然生长出来的上下文,质量往往越来越差:闲聊、过时的结论、中间过程的噪音都留在里面,持续消耗模型的注意力,仅仅依赖压缩是不够的。
管理 agent 的本质,是管理 context。而在会议室式的多 agent 里,每个 Agent 从一个人类岗位的视角补充意见,但任务本身并没有被整理成可交付、可验证、可合成的结构。这只是把人类的组织形式搬到了模型上,而不是面向 Agent 的能力边界来设计系统。
解决方案:转向以 Goal(Loop)为核心的 context 管理
runtime 和 session 只是临时的工具,把模糊的目标拆解为可闭环的 AI 任务。
AI 的特性是需要明确的目标和验收标准。每一个核心线程,工作习惯都转向了以 goal,也就是 loop 为核心。所以最佳的上下文方案,一定是在一开始就有意识地设计,而不是随着对话精进。真正适合交给另一个 Agent 的任务,应该像一个可以独立交付的完整子问题。它不一定很庞大,但必须完整。DSH-projects 有意识地让每一个 agent 去维护每个任务的组织,同时提供自动任务(定时重复运行的任务),帮助你丝滑地构建自己的任务循环。
对于每一个任务来说,目前 session 的问题是:绝大多数有价值的 context,都淹没在动态的对话里。但实际上,一个任务固定的索引是很简单的,往往就是一些明确的目标、仓库的位置、验收的标准、文档的位置。
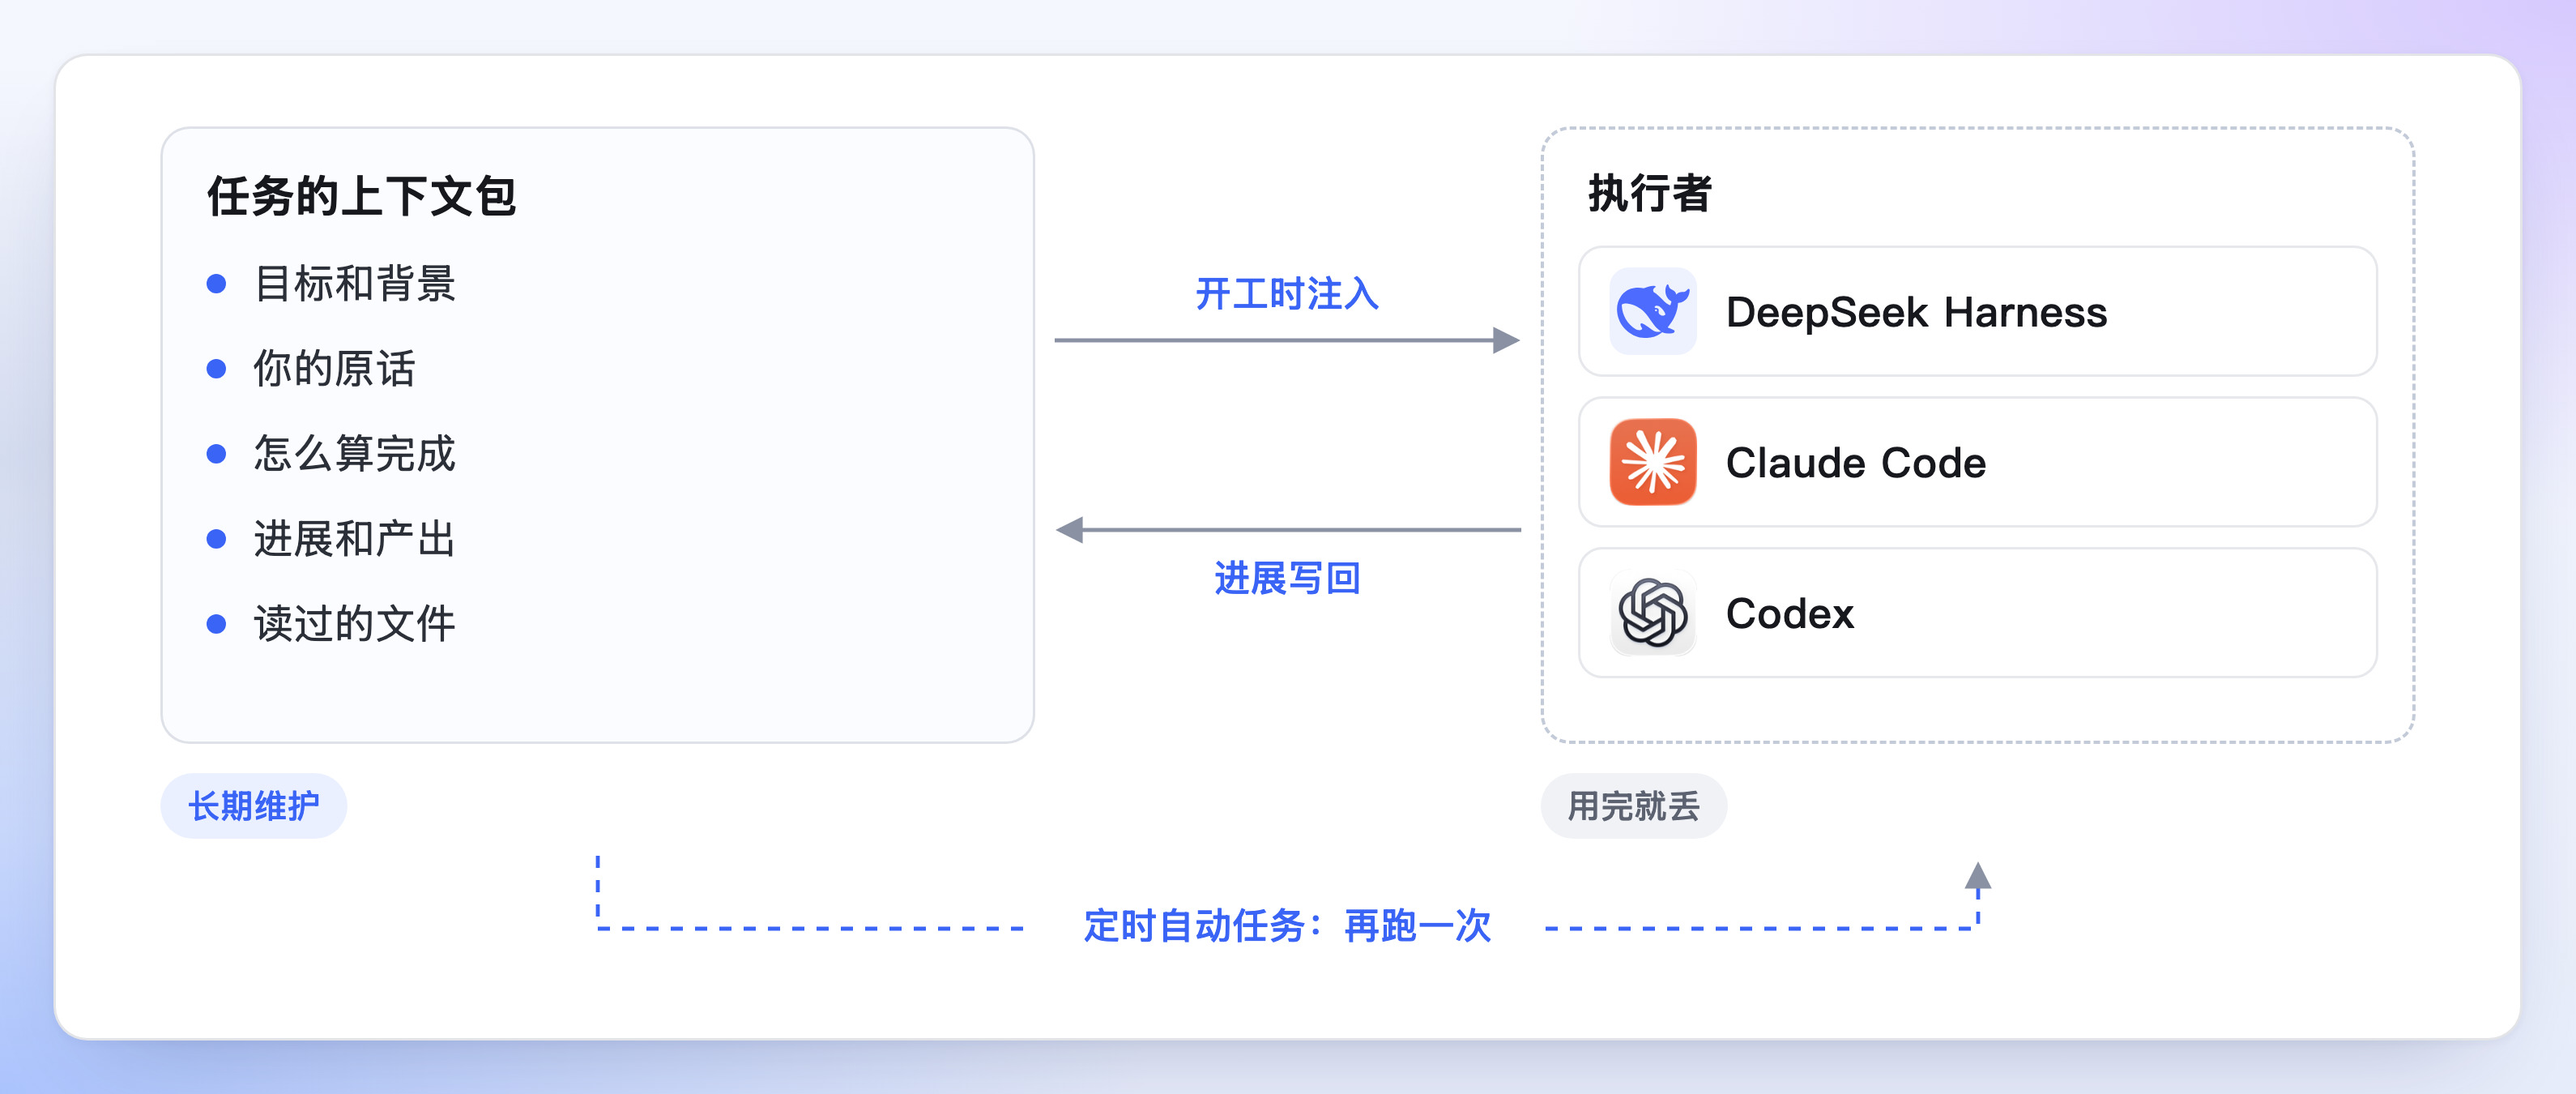
所以人只需要讲清楚三件事:要做什么,上下文在什么地方,标准是什么。然后 AI 把它们拆解成一个一个任务(thread)的上下文包。上下文包可以粗略理解为一个 goal 文件,这是我们真正要长期维护的,每次注入,每次更新。
至于执行,那些临时的 agent 其实都是 tool。它们的状态是脆弱的,就是一个 runtime,每次重新注入就好了,实际上不太需要维护。
隐藏配置的细节:相信模型的能力,提供看板而非表单,一切交给 AI
现在市面上类似的多 agent 产品都过度暴露了。Multica、Raft 通过群聊、通过工单的传递,确实很好地提供了一种组织方式,底层的抽象也做得很好,我借鉴了它们的思路和构造方式。但对人来说,建频道、配角色、做分工,本身也是一件费力的事情。
细节是需要包裹的。上下文怎么组装、缓存在哪一层命中、token 怎么省,这些都是引擎盖下的事,不该露到用户面前。包裹得好,还有实际的回报:稳定的部分放在前面,模型就能复用上次的阅读成果,而缓存命中和不命中,成本差着一个数量级。
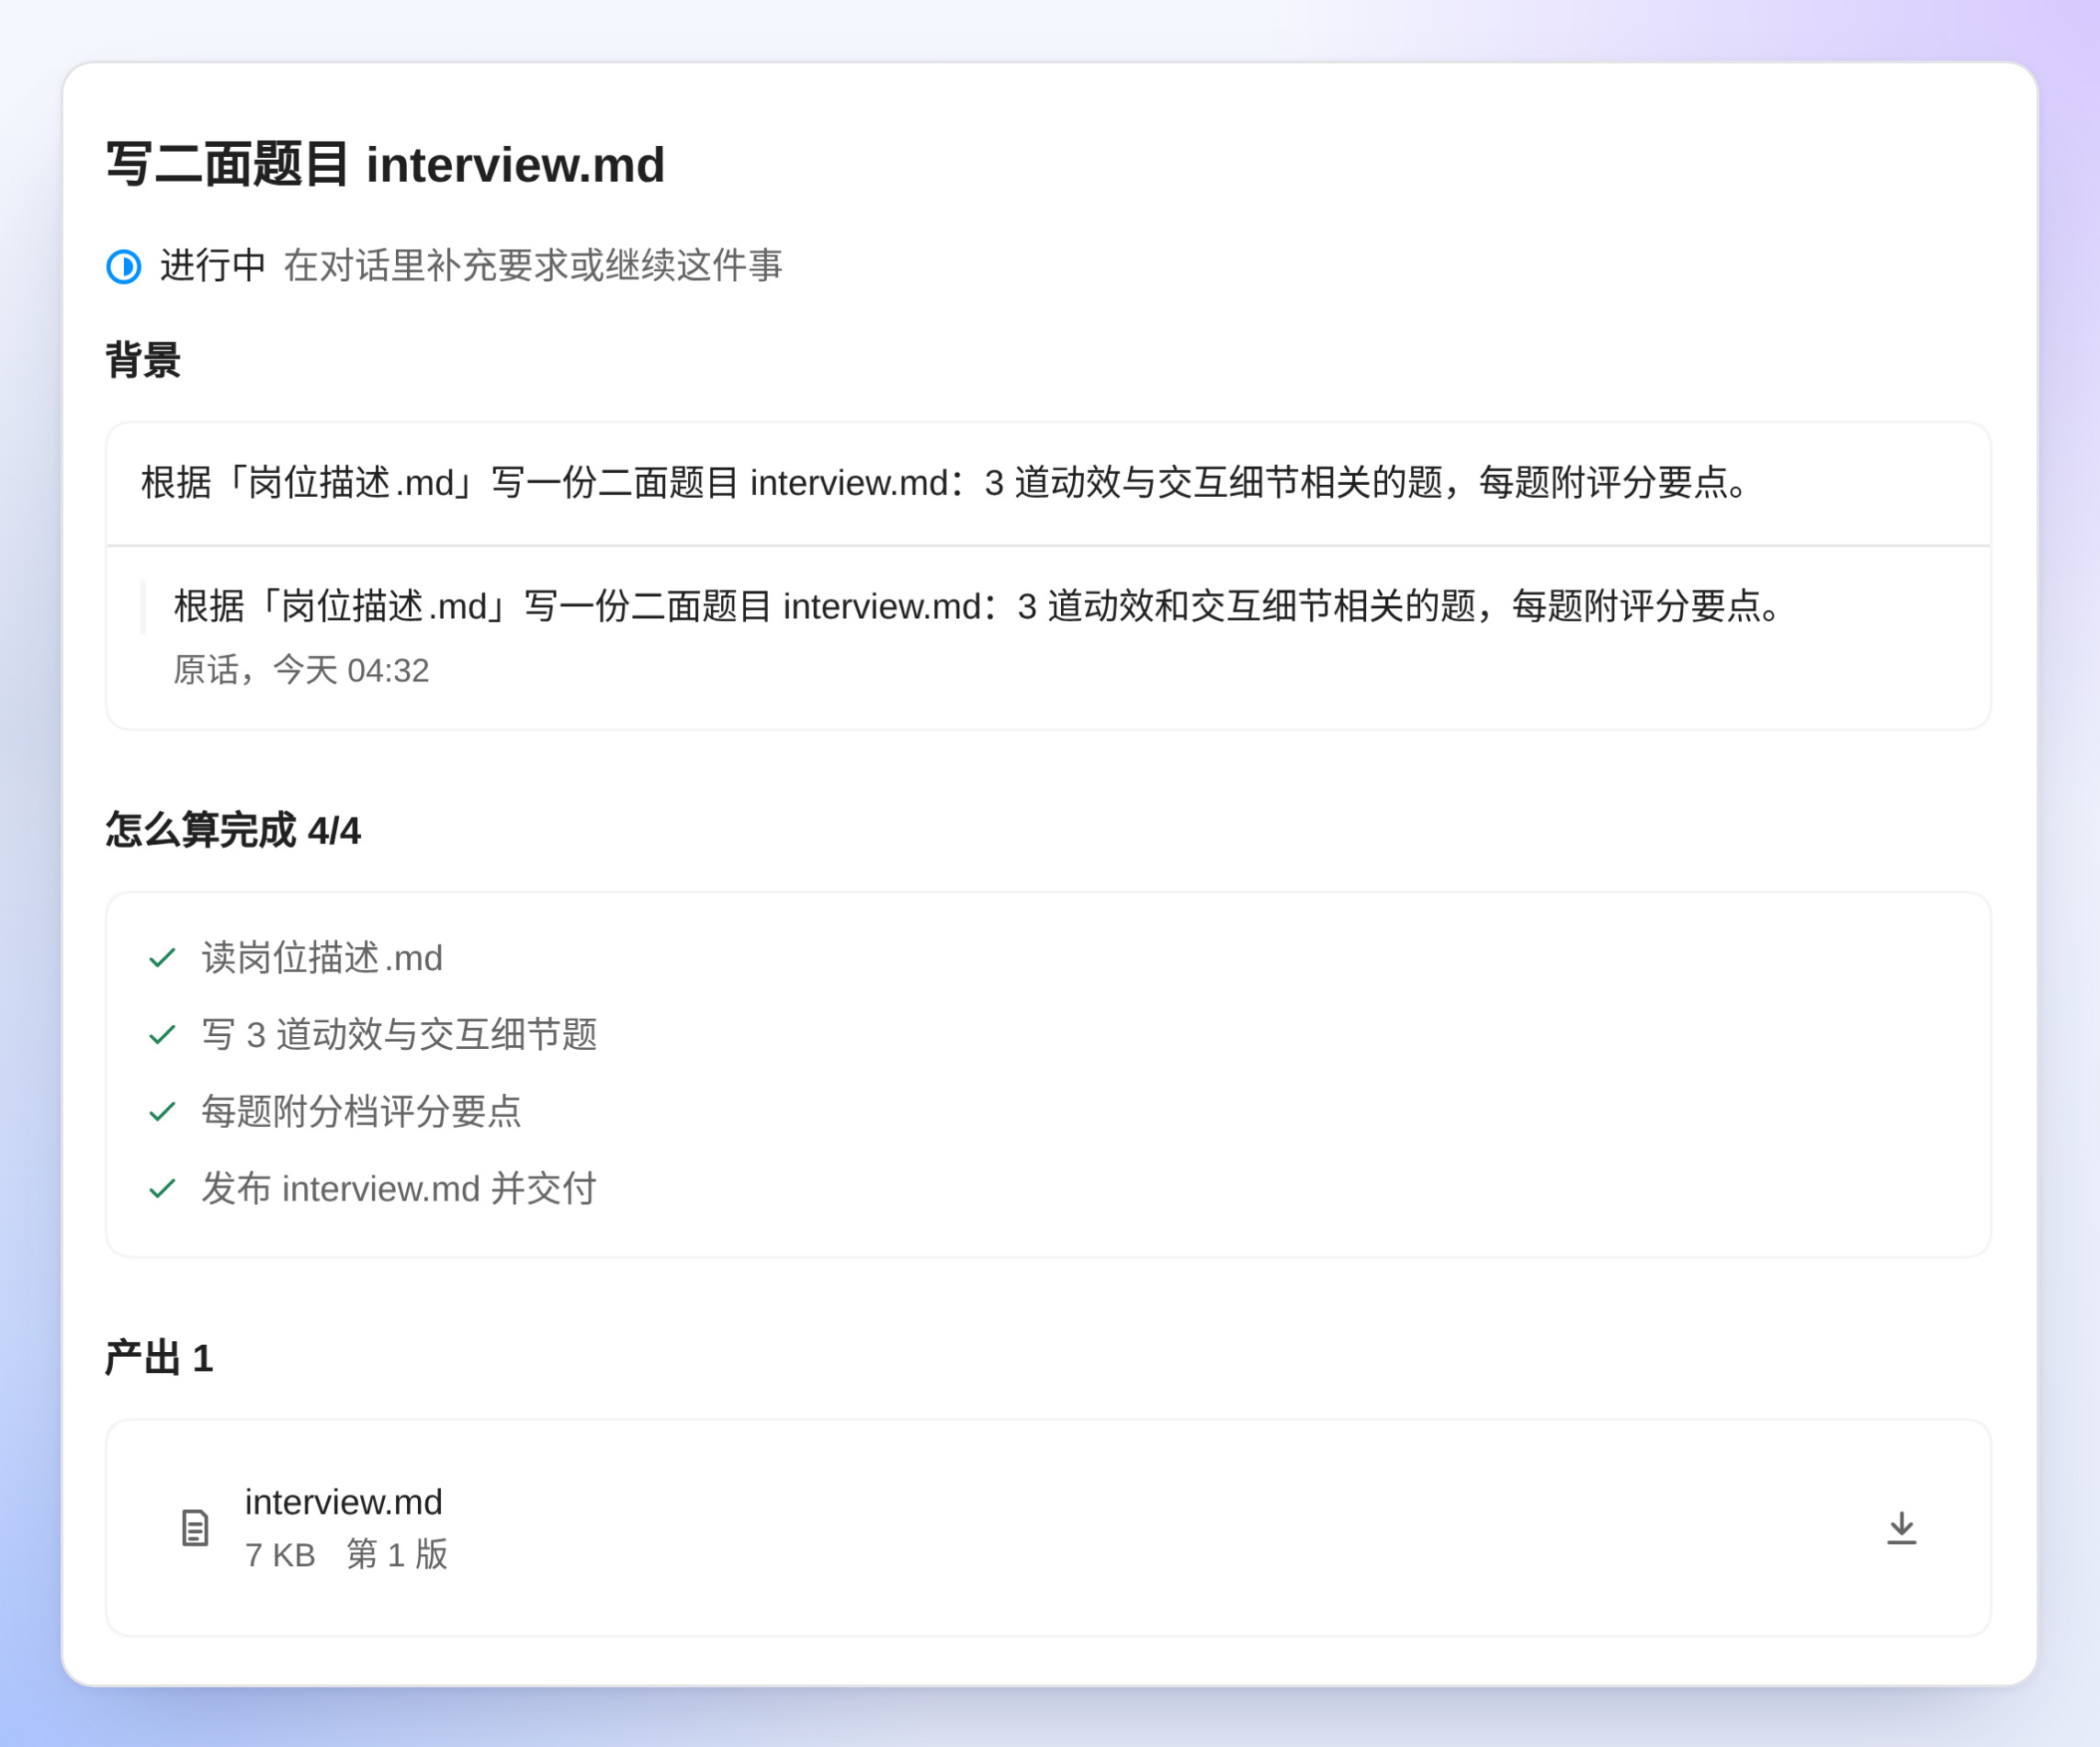
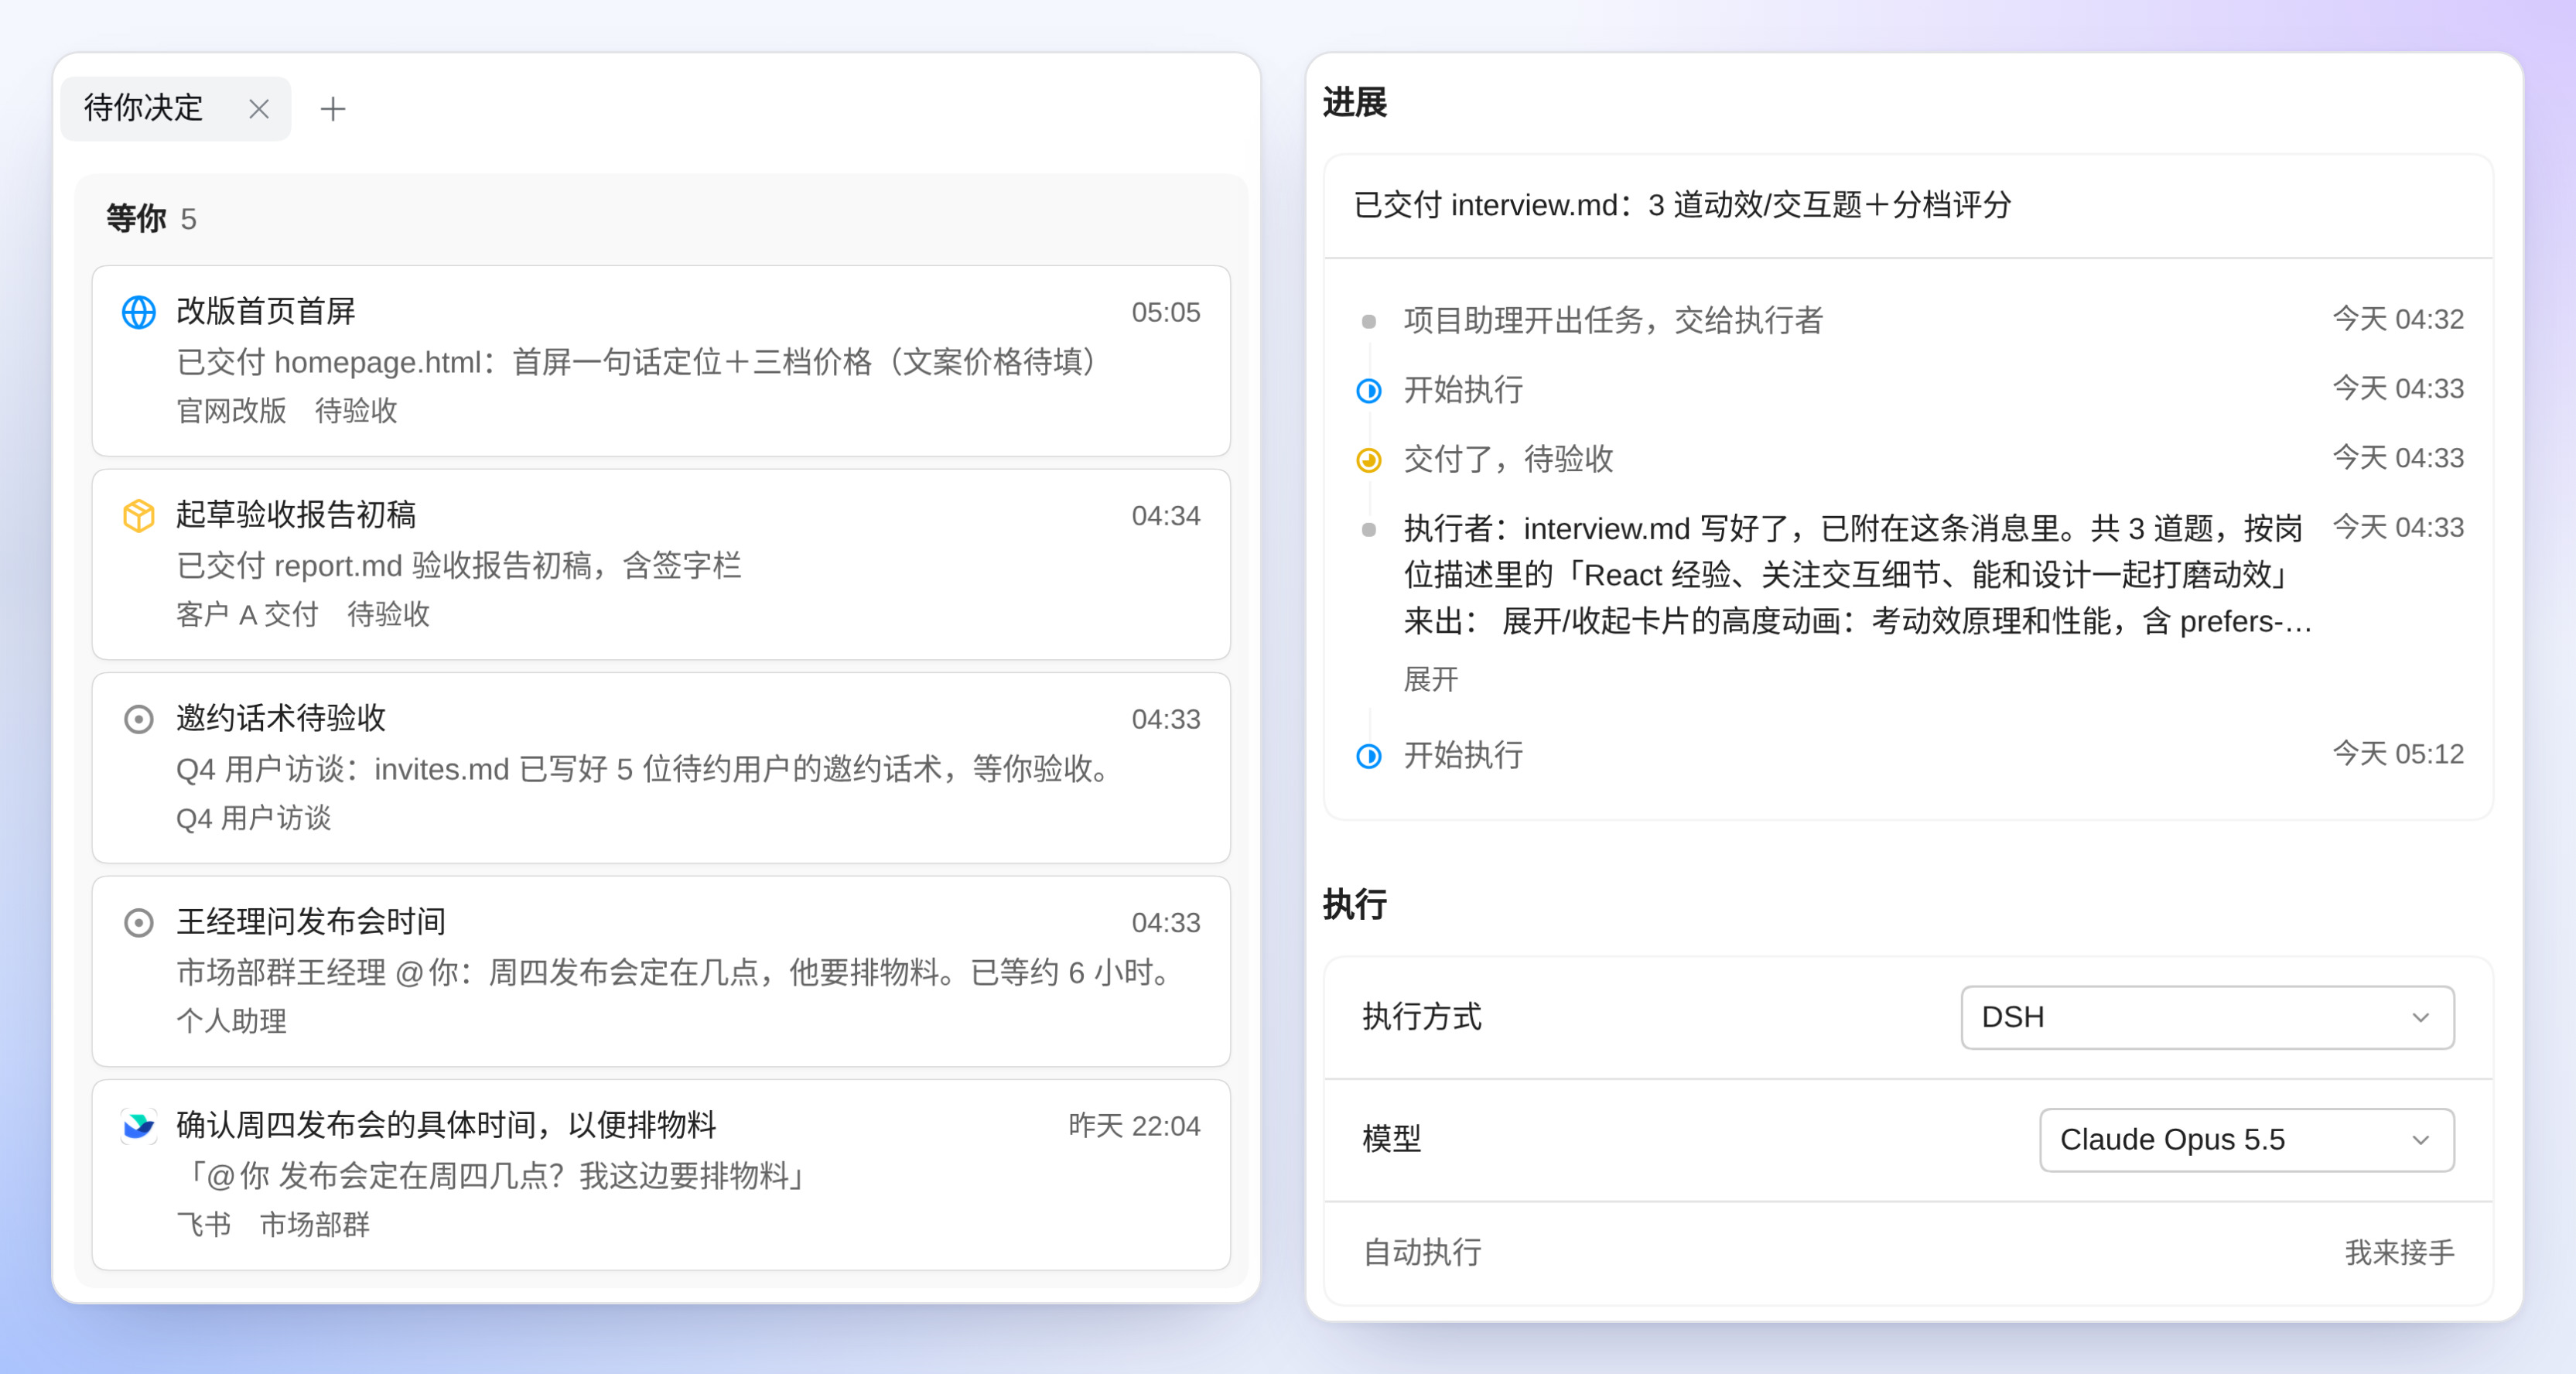
所以在 DSH-projects 里,没有要起名字的 agent,也没有要配的技能。但每件事做到哪了、交给了哪个模型,都看得见:每个任务有一页详情,需要你的事都在一块「待你决定」的看板上。
全面的 context 收集
把人从信息的搬运里解放出来,走向 always-on、真正懂你的理想 AI。
一个好的 AI 要能接过这一层,首先需要摄入你足够多的 context。这就引入了我们最重要的一个设计:上下文的收集。屏幕上在做的事、飞书里的消息,源源不断地进来,每 10 分钟整理成一条时间线;电脑里的文件,需要时去读。全部只读,随时能关。
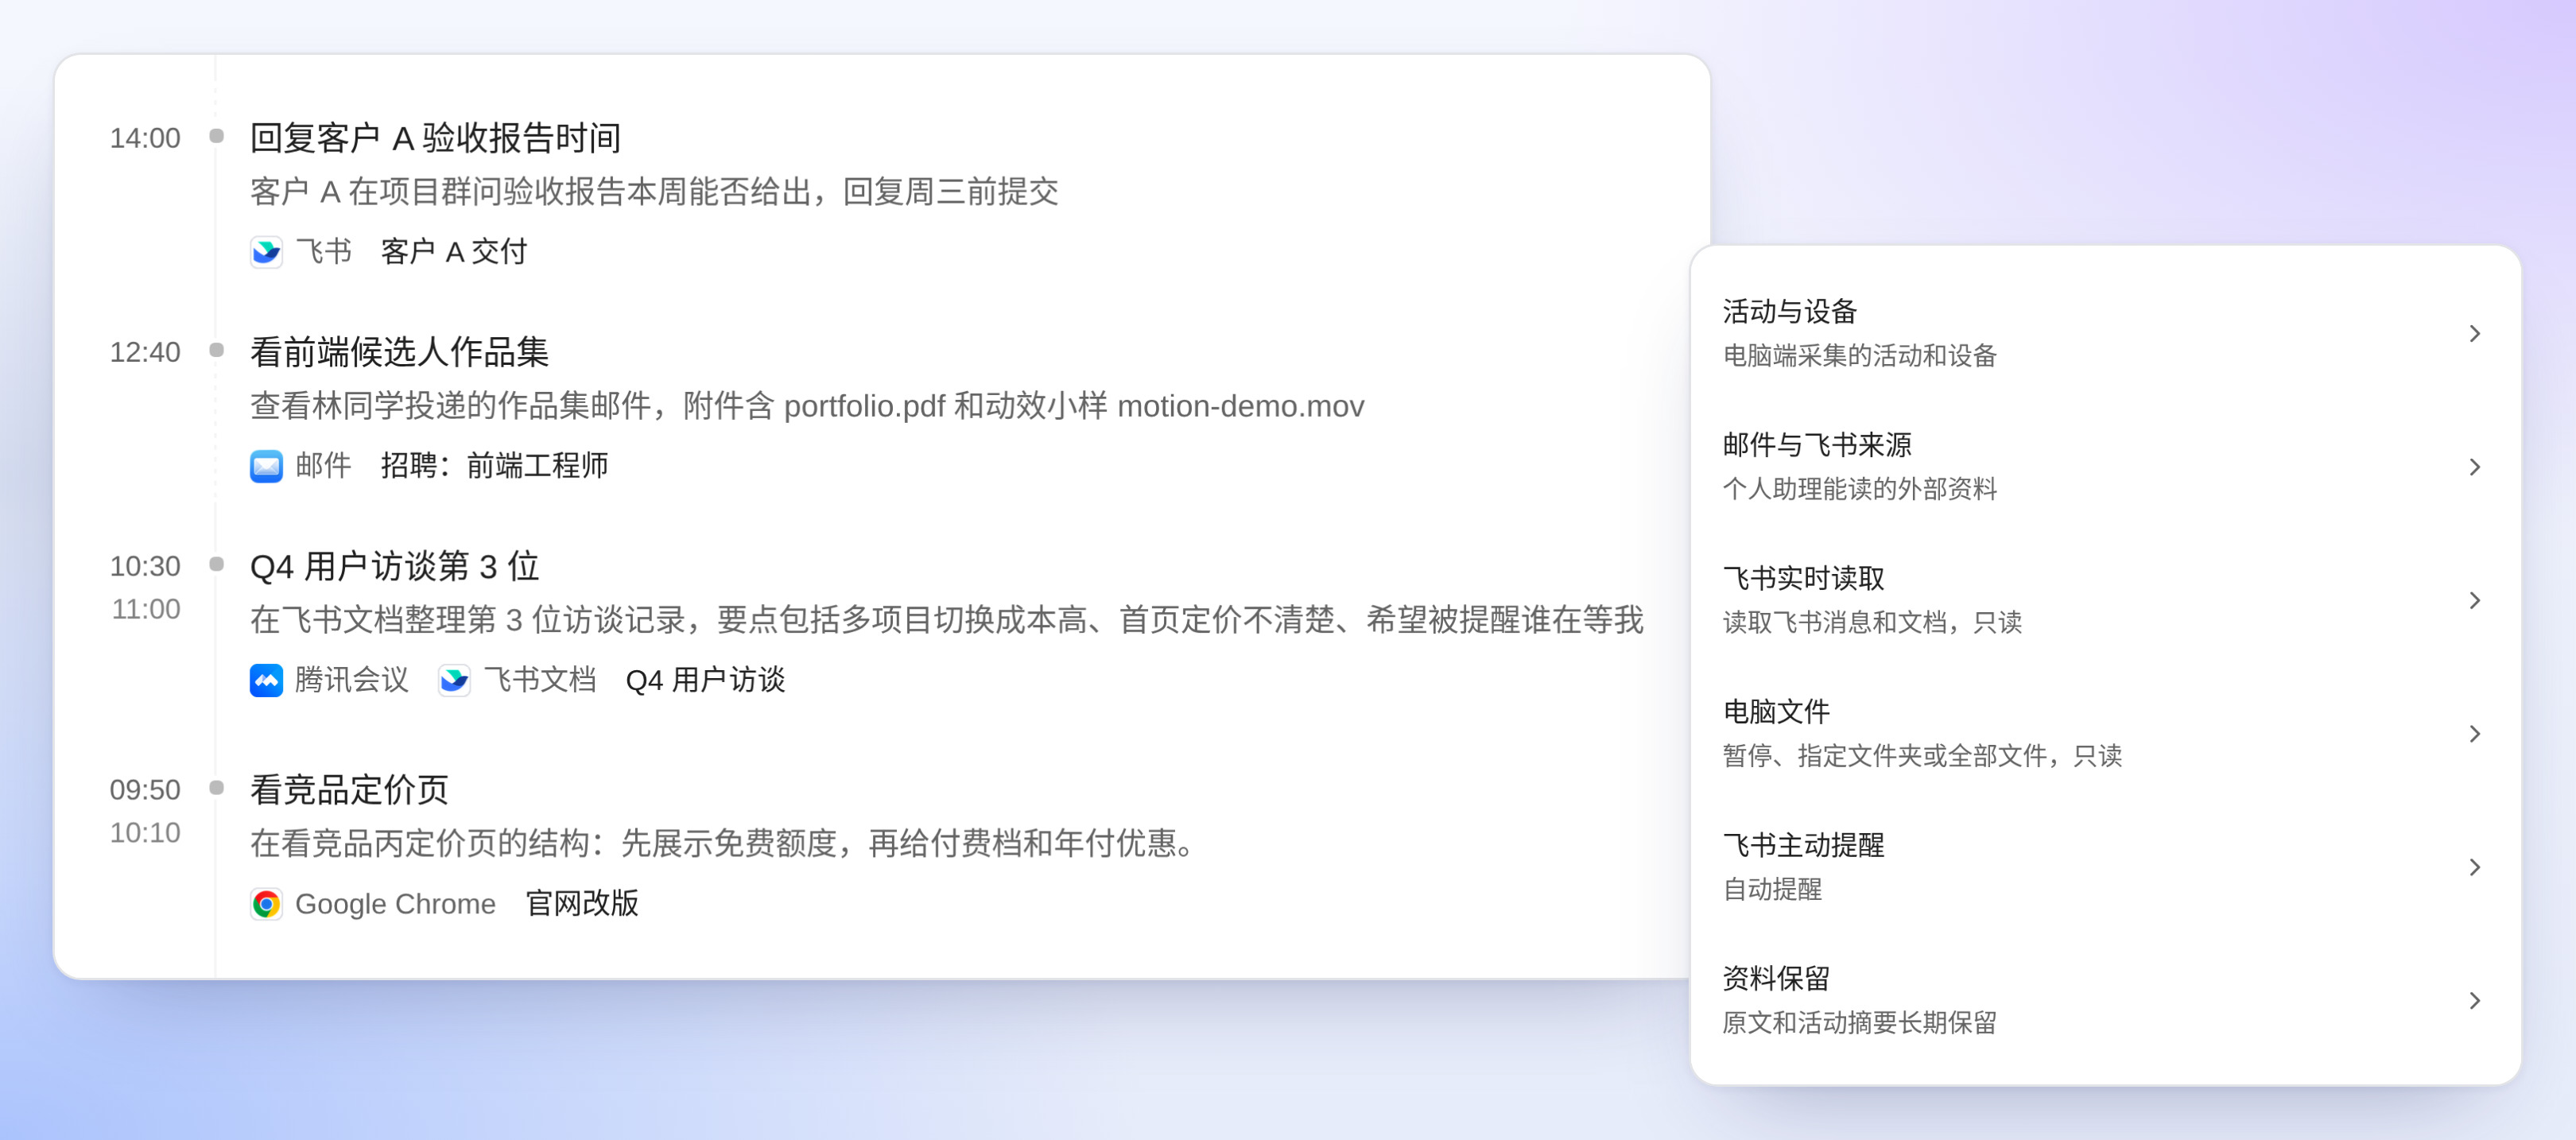
自动获取不是一件新鲜的事情,以 Screenpipe 为代表,还有 AirJelly、Littlebird,包括 Codex 内置的 Computer History,都早就存在了,但它们大多没有打通从 context 到行动的循环。
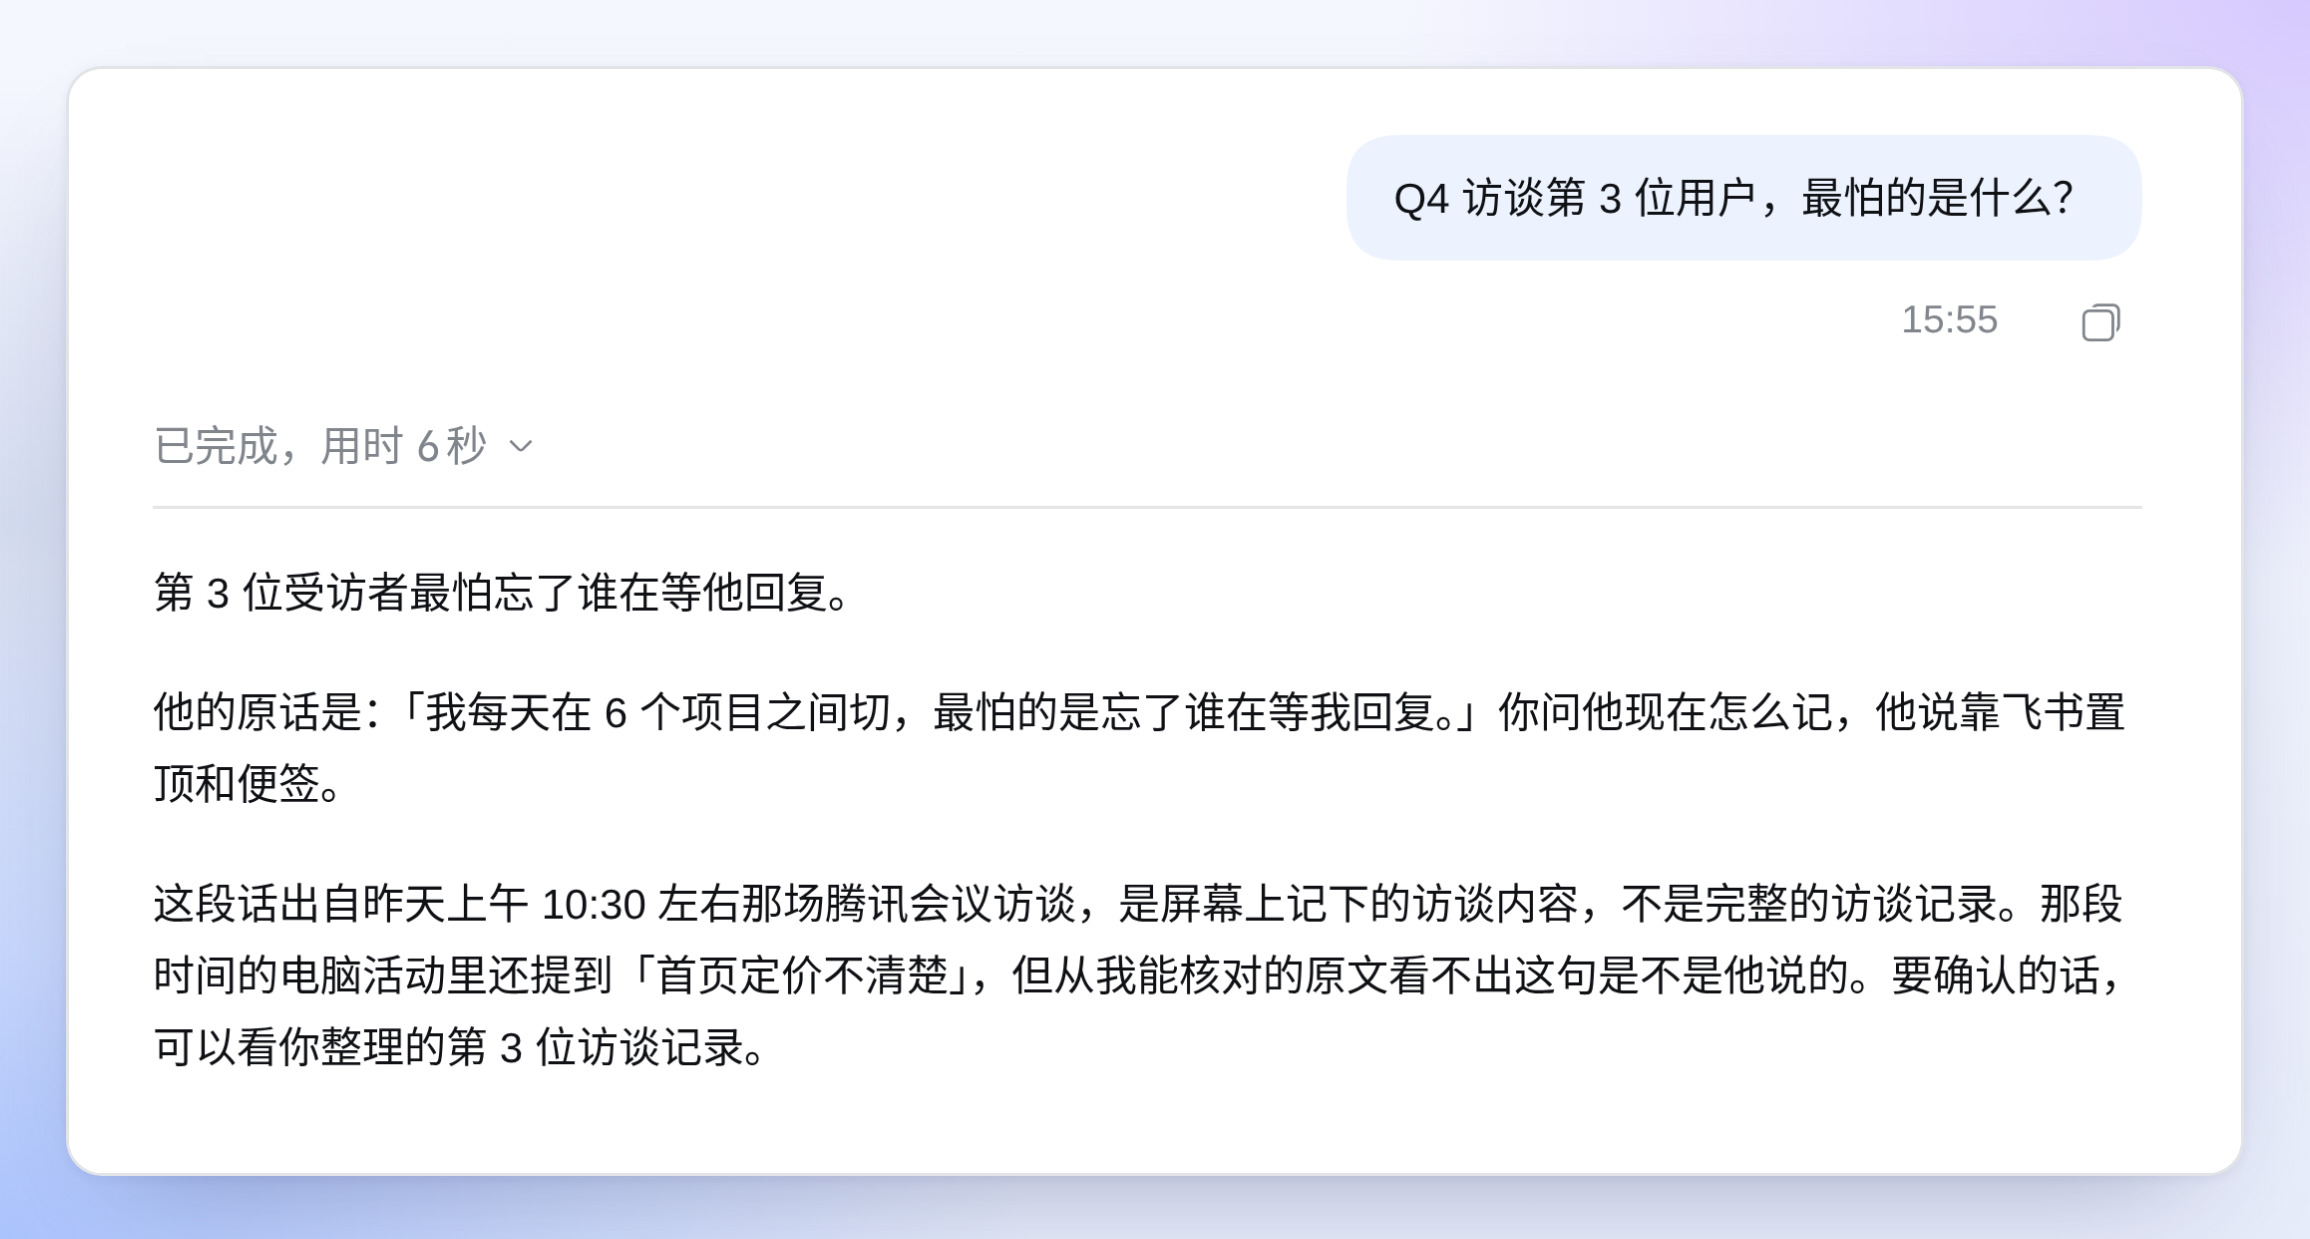
我认为这是未来的工作模式:人只在真正的接入口表达喜好、价值,给出关键的指引,而不是像今天这样沦为信息的搬运工,伤害注意力。让人能够专注于真正重要的事情。
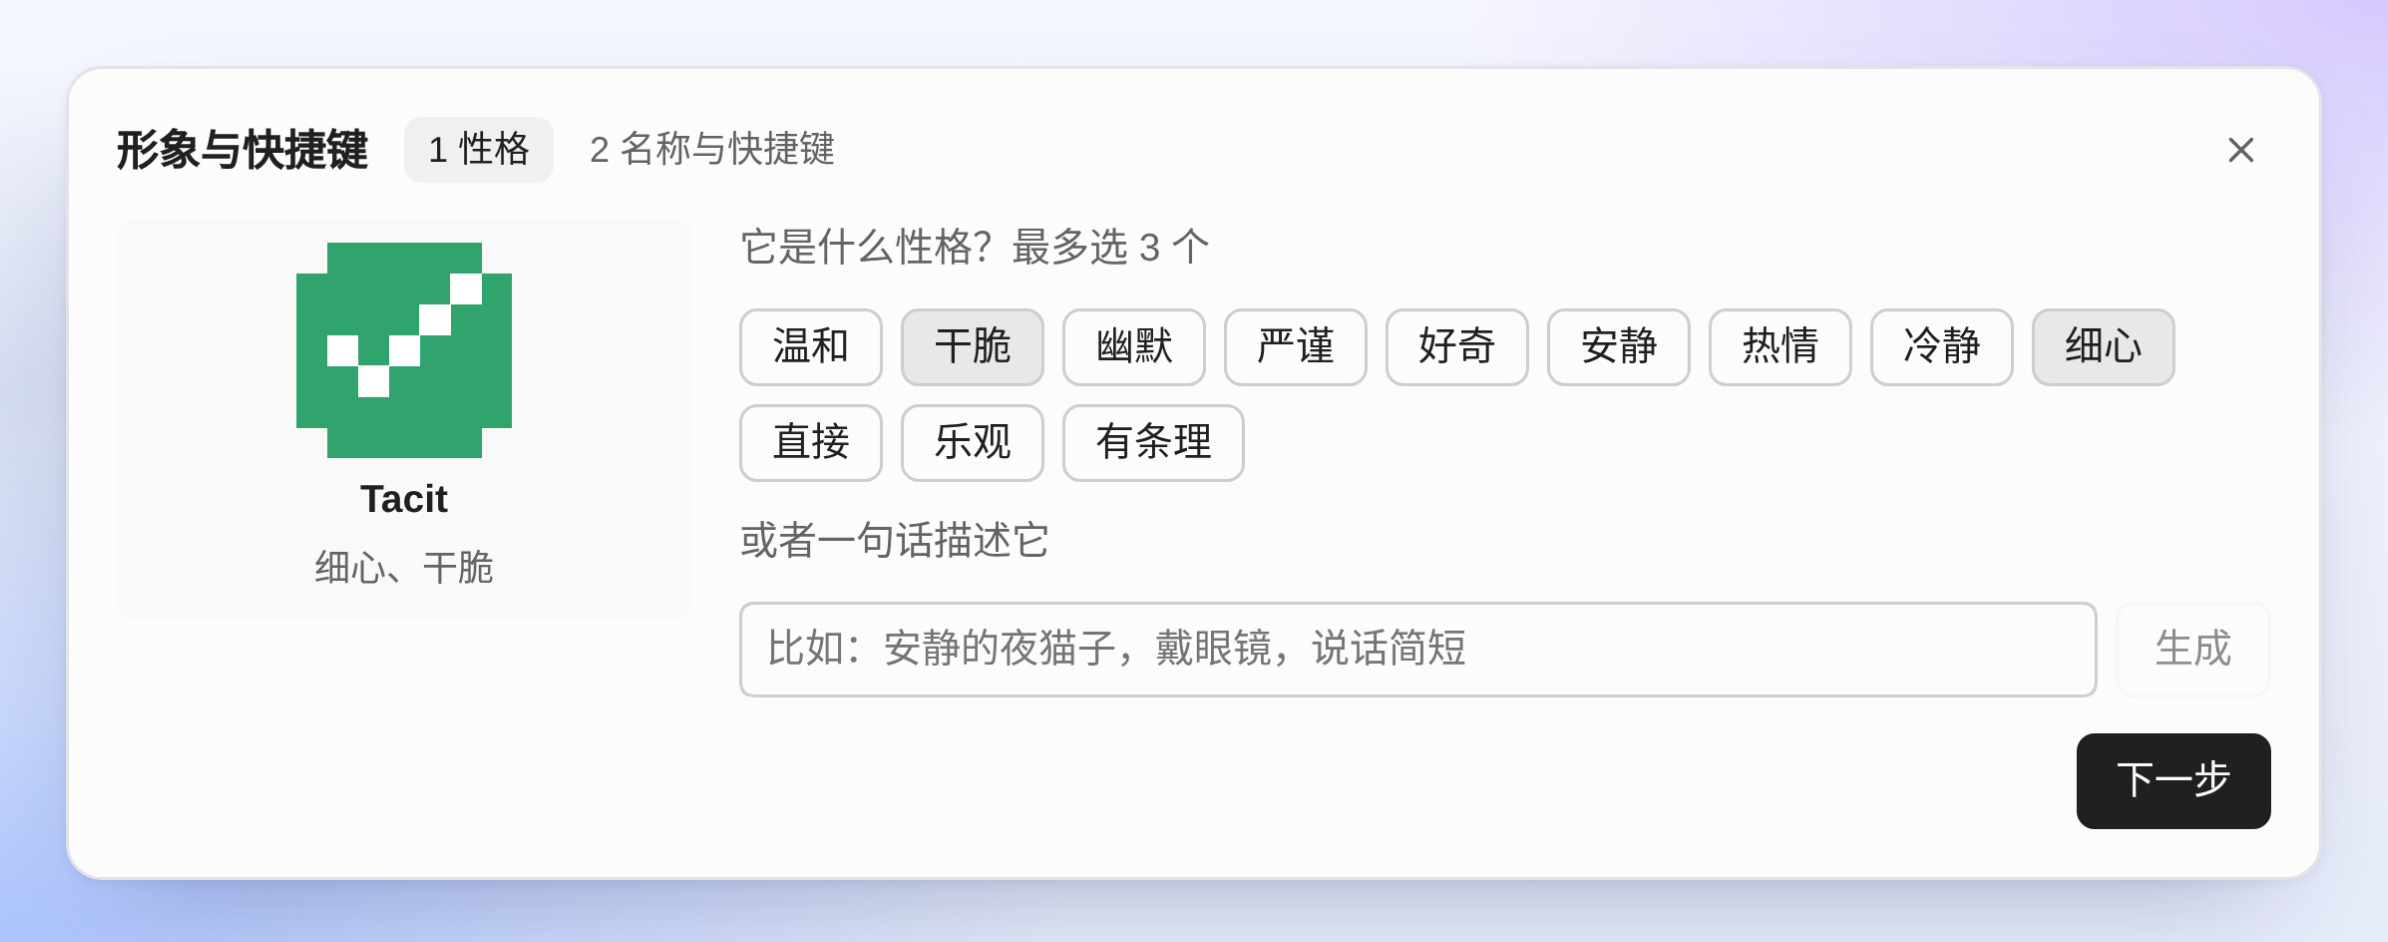
DSH-projects 里核心的助理,名字默认叫 Tacit,内涵是默会,心领神会。因为我认为,真正好的 buddy 应该在你开口之前,就了解一切相关的上下文。
最大的挑战:如何科学地分解任务
今天最大的问题是 coordinator,也就是负责拆任务的助理,能不能科学合理地规划任务的分工和粒度。所以我们推荐使用 Claude Opus 5.5 或 GPT-6 Astra 这样的强模型,作为个人助理的模型,也就是帮你配置的那个助理,来尽可能把任务拆好。随着模型智能的不断提升和分工 skills 的打磨,这件事会越做越好。
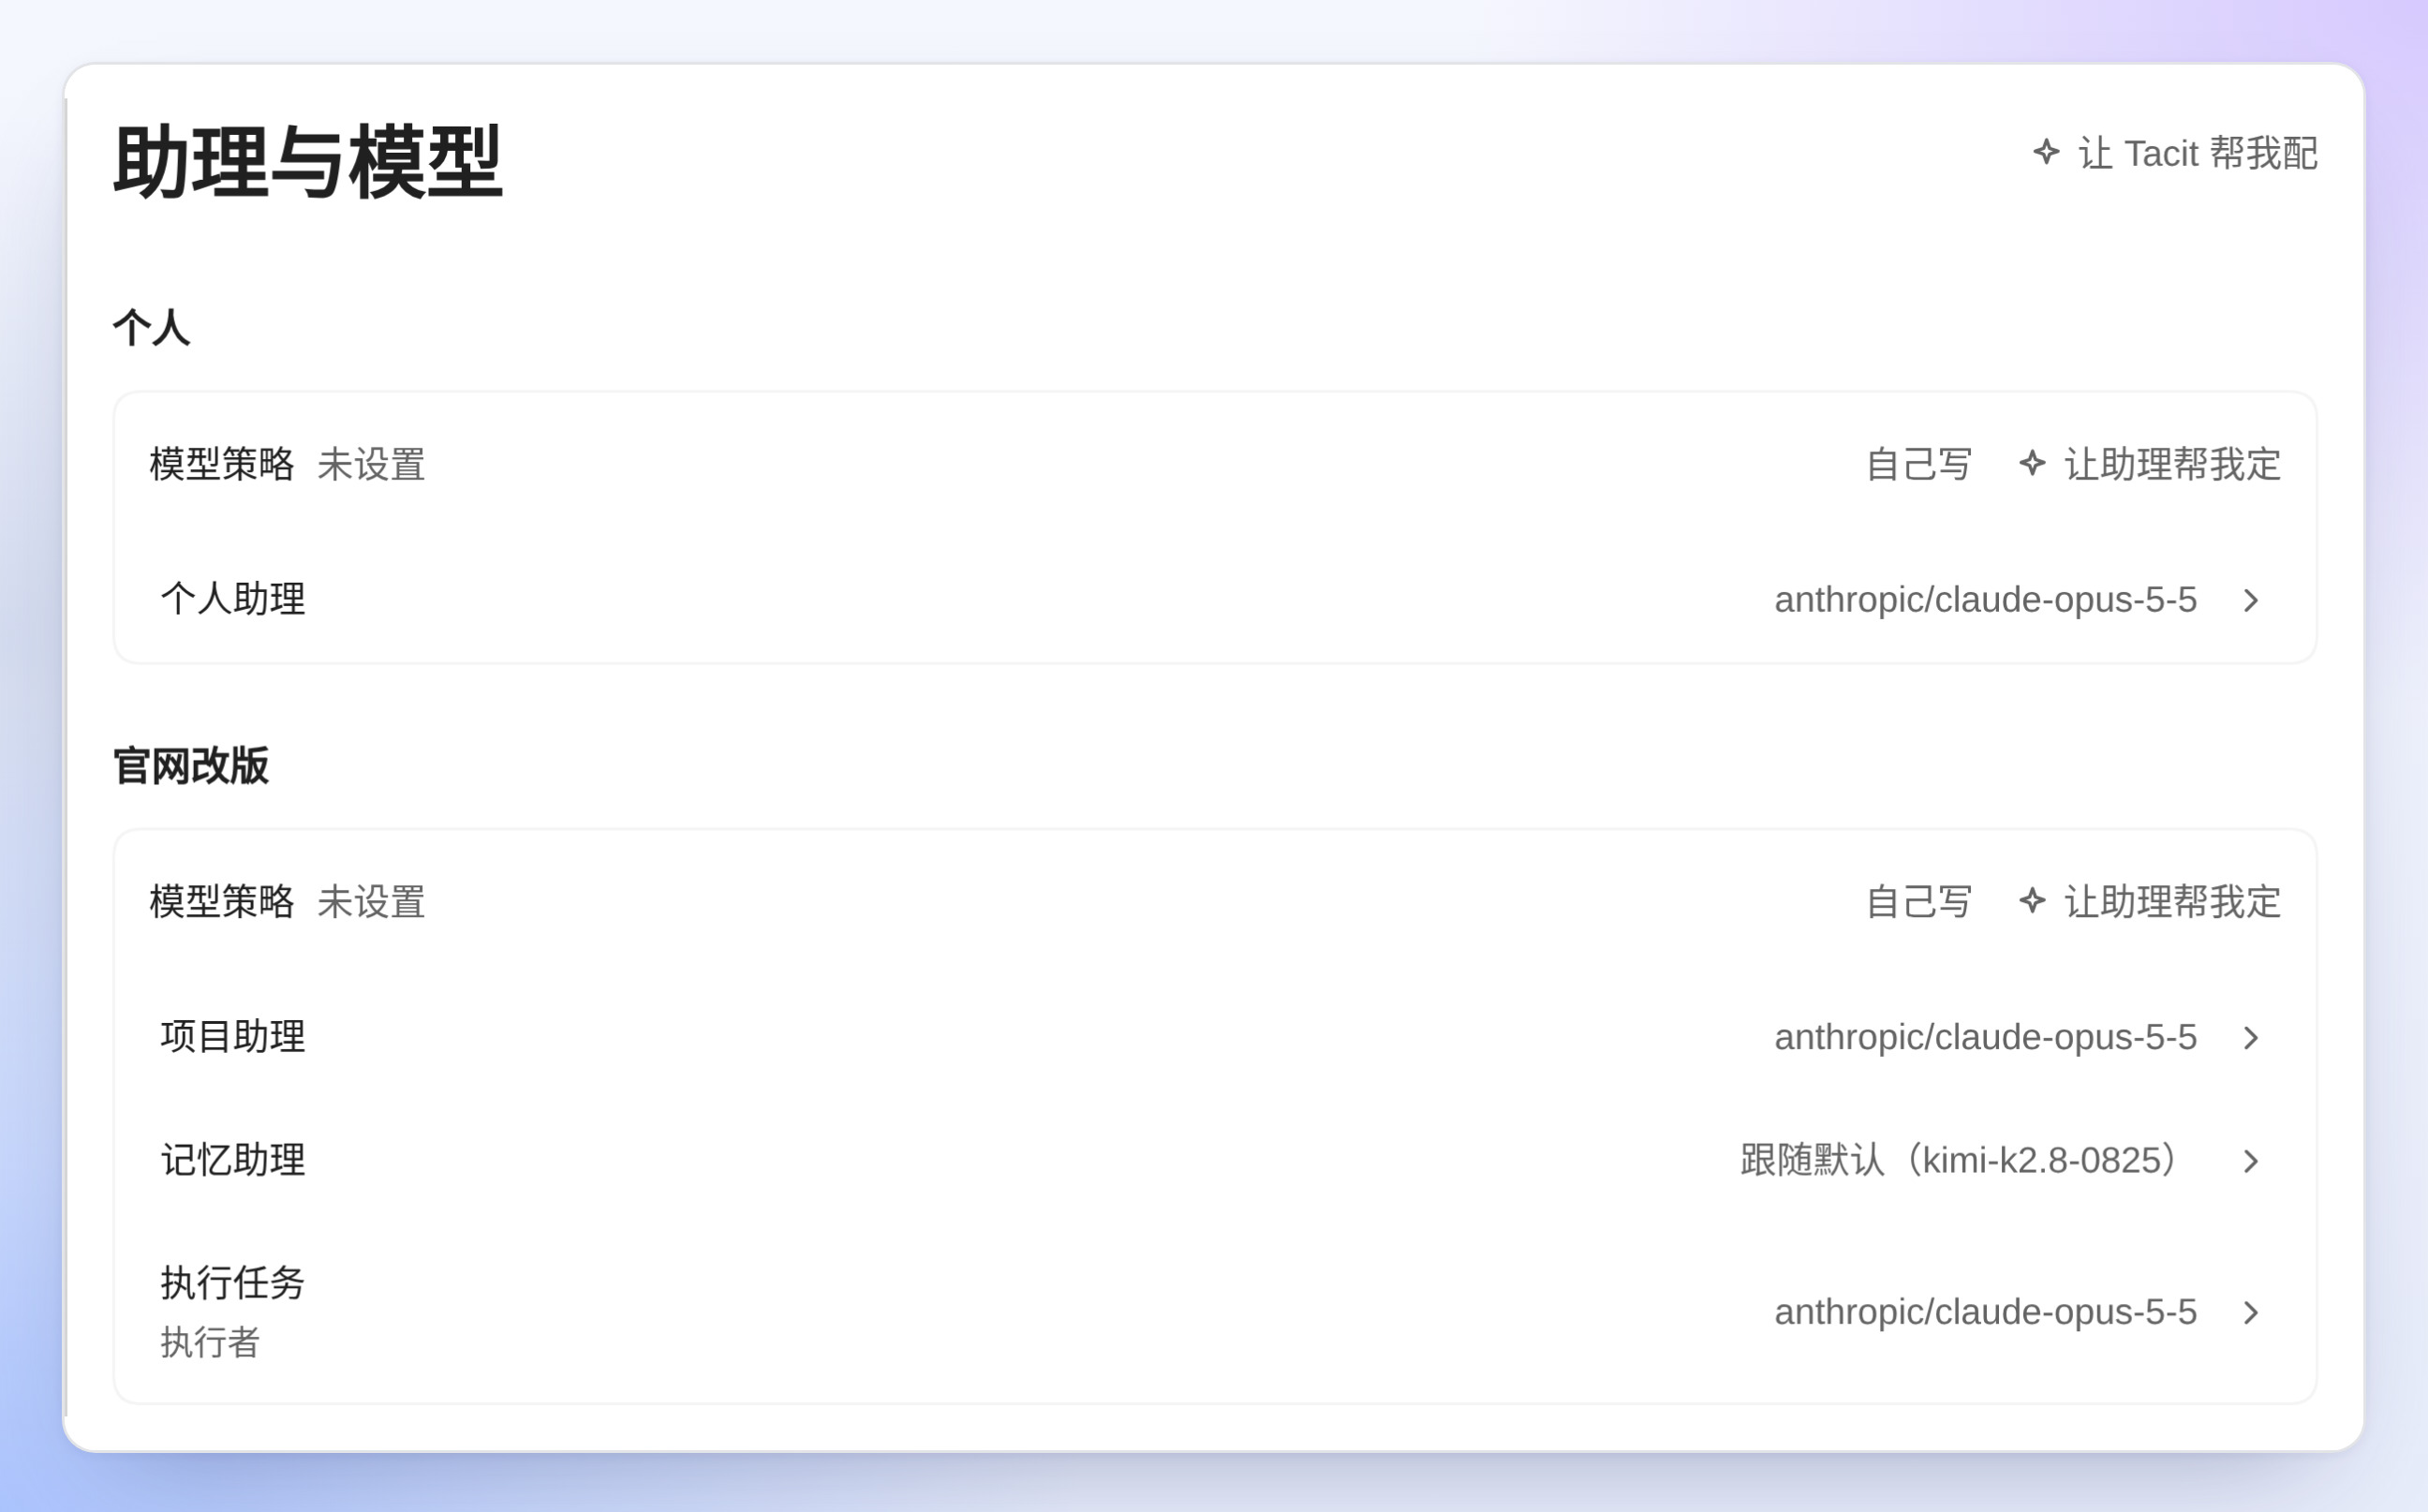
欢迎体验。
DSH-projects,你的下一个 Agent 产品,不一定需要有 Agent。
更多阅读: